
Francesc Sánchez


Google ens va convidar a Search Central Live Deep Dive Europe 2026, el congrés que organitza per a professionals del SEO i que aquest any es va celebrar a Barcelona. El primer dia estava dedicat a com Google rastreja la web. El segon, a com l'interpreta i decideix què emmagatzemar a l'índex. Aquest article cobreix aquell segon dia, organitzat amb un fil conductor: entendre com processa Google el contingut del nostre lloc web per saber què fer per indexar-lo.
És el format més tècnic de Search Central Live: llargues sessions amb l'equip de Google Search i espai per fer preguntes. Per a una agència que treballa amb SEO i desenvolupament, és una oportunitat per escoltar de primera mà com funcionen els seus sistemes i contrastar-ho amb el que veiem cada dia en projectes de clients.
La indexació ja no és una formalitat. Google només guarda una petita part del que troba, i el context ha canviat: hi ha cada cop més llocs web i aplicacions construïts amb JavaScript, molts ja generats amb IA; la pàgina de resultats incorpora resums i mòduls que no fan que tot sigui un enllaç blau (ho tractem en SEO el 2026), i els assistents d'IA llegeixen el lloc web amb capacitats diferents de les de Google. Si la pàgina no arriba bé a l'índex, la resta del treball de SEO és inútil.
L'article segueix el viatge que fa una pàgina des de quan Google la troba fins que decideix si la desa. En cada pas, expliquem què fa Google, on els llocs web solen fallar i què s'hauria de comprovar. Aquests són els nostres apunts de classe, no la documentació oficial de Google: per a més detalls, la documentació de Search Central continua sent la referència. Si algun concepte no et sona, el nostre Diccionari SEO els llista.
Des que Google troba una URL fins que decideix desar-la, hi ha sis passos:
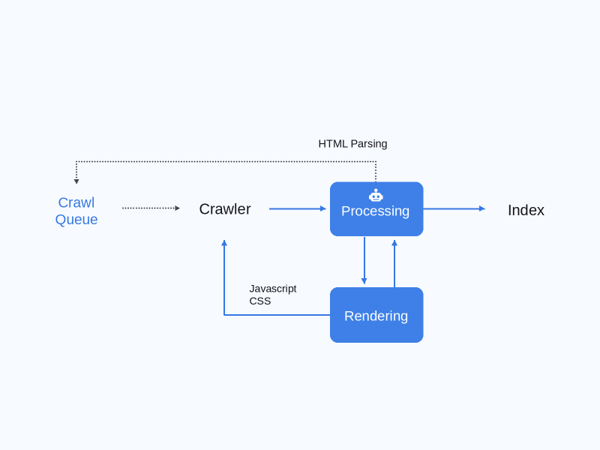
Un problema en un pas condiciona el següent. Una pàgina que Google no pot renderitzar no arribarà ben interpretada en la deduplicació, ni en senyals, ni en l'índex. Per això el més útil és saber en quin pas es perd cada pàgina.
Google no rastreja tota la web ni sempre al mateix ritme. El que visites depèn del que trobi i de com respongui el servidor, i aquest és el pressupost de rastreig. El primer dia del congrés vam parlar més d'això, i les respostes del servidor són les que més l'afecten:
Respuesta | Qué pasa | Qué hacer |
5xx (500, 502, 503) i 429 | Googlebot alenteix el ritme. Si persisteixen, pot deixar d'indexar les URL | En manteniment temporal, serveix el 503 |
Temps de resposta lents o temps d'espera | Com més temps triga el servidor, menys URLs rastreja | Millorar el rendiment |
5xx a la robots.txt | Google pot deixar de rastrejar tota la web fins que es recuperi | Disponibilitat de fitxers de monitoratge |
3xx | Cada salt és una petició extra. Les cadenes són especialment dolentes | Enllaç a l'URL final |
Soft 404 (200 amb contingut "no trobat") | Google continua seguint-los | Retorna un 404 o 410 real |
404 / 410 | No deixen de rastrejar-se, però Google els torna a revisar. El 410 s'elimina una mica més ràpid | Fes servir el 410 si no tornen |
200 amb contingut duplicat o pobre (paràmetres, filtres, paginacions infinites) | Consumeix pressupost sense afegir valor | Controla'l amb robots.txt, canònic i enllaçat |
304 No Modificat (amb ETag o Últimament Modificat) | Google no ha de tornar a descarregar la pàgina | Implementa aquestes capçaleres |
Per veure aquestes respostes en la pràctica, tenim la guia de Google Search Console i una publicació sobre com corregir errors 5xx i 4xx.
Altres decisions que es van aclarir:
Quan Google arriba a una pàgina, analitza l'HTML seguint els elements del DOM. Primer, separa el que considera el contingut principal de la resta. Després llegeix el capçal (canònic, hreflang, títol), extreu els enllaços i consulta les etiquetes meta robot.
Els enllaços són la manera que té Google de descobrir noves pàgines, i han de ser . Qualsevol altra solució és un risc.
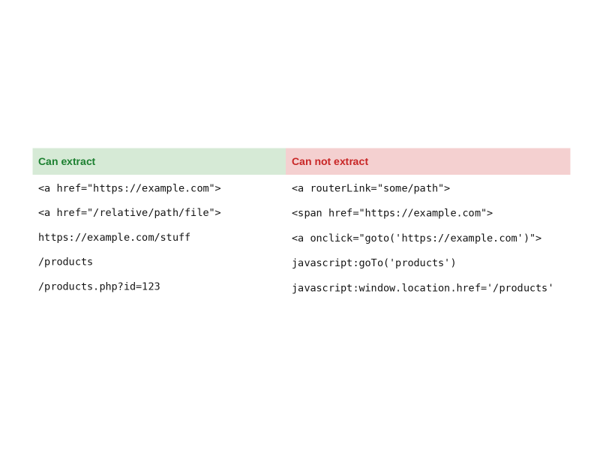
En webs fetes amb frameworks JavaScript, és una de les primeres coses a tenir en compte: si el menú o els productes s'obren amb un onclick o un routerLink, Google no els veu com a enllaços.
Al cap, pots indicar regles per a tots els robots o per a un específic. Les que has de saber:
Directiva | Què fa |
noindex | No indexa la pàgina |
nofollow | No segueix enllaços. A nivell de pàgina té poc sentit; s'aplica més enllaç per enllaç |
none | És igual a noindex més nofollow |
nosnippet | Indexa la pàgina, però sense fragments ni resums a AI Overviews |
data-nosnippet | Atribut HTML (no meta etiqueta) que només exclou una part del contingut dels resultats |
max-snippet | Limita la longitud del fragment, normalment amb un nombre de caràcters; -1 és il·limitat |
max-image-preview | Configura la mida de la imatge: cap, estàndard o gran. Gran pot ajudar-te a obtenir visibilitat a Discover |
max-video-preview | Estableix la durada màxima de previsualització |
notranslate | Evita la traducció als resultats i a Chrome. Ús inusual |
noimageindex | Indexa el contingut, però no les imatges. Cas poc habitual |
Les directrius de limitació són una decisió empresarial: si donem la resposta completa a la pàgina de resultats, l'usuari no té motiu per clicar. Tot i així, per a la majoria de llocs web l'objectiu és la màxima visibilitat, i la combinació recomanada per la presentació és aquesta:
max-image-preview:large, max-snippet:-1
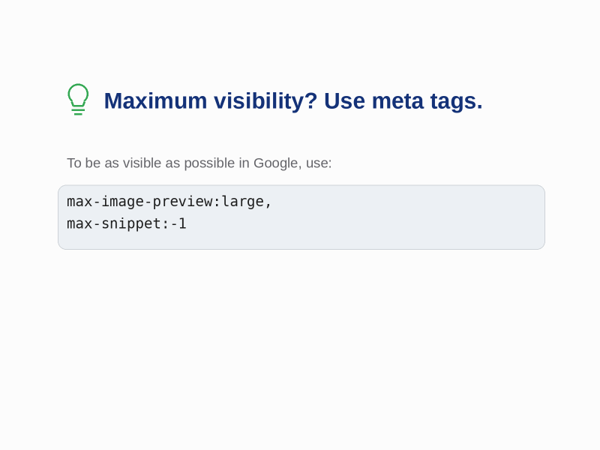
Dues aclariments més. La robots.txt regles: si bloqueja l'accés a recursos que després volem millorar amb etiquetes meta de robots, són inútils. I les etiquetes meta de robot es poden incloure amb JavaScript, però és inestable, especialment davant dels canvis. Millor evitar-ho.
Google ha millorat molt la rastreig i indexació del contingut en JavaScript, però encara no és perfecte. El que vol és entendre què veu una persona per saber si la pàgina respon, i no sempre ho aconsegueix. La primera vegada, gairebé mai.
Una pàgina amb JS passa per dues cues: la cua HTML i després la cua de renderització. El camí és una mica més llarg, però si el contingut està ben servit, Google acaba recollint-lo. El que has de deixar clar és que CSS i JS canvien l'aspecte de la pàgina, i el resultat pot ser molt diferent de l'HTML pur. Si Google no sap renderitzar bé, la majoria d'enllaços i menús no els detecten.
Tant si el teu lloc web està creat amb React, Vue o Next.js, la nostra guia de SEO basat en JavaScript entra en més detall.
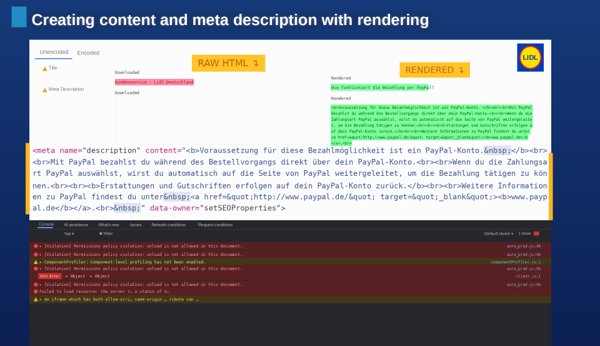
Cas mostrat a la presentació: el títol i la meta descripció de l'HTML en brut no coincideixen amb els del renderitzat.
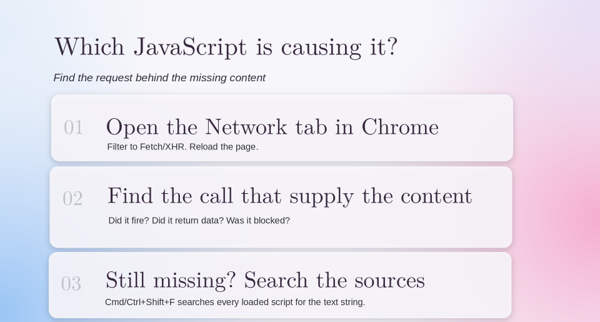
Mètode per trobar la sol·licitud darrere del contingut que falta.
Els sistemes de Google recullen contingut en JavaScript força bé, però altres assistents d'IA encara no ho fan. Per això és més segur servir-lo amb SSR, és a dir, renderitzat al servidor. També val la pena preguntar-se si els bots d'IA poden accedir a tot el contingut de la web, si vols.
El CMS sense cap és net i segur, però el resultat sovint no és gaire llegible per Google, fins i tot si l'usuari el percep bé. Això es pot compensar parcialment amb un bon marcatge de dades estructurades.
Per a les aplicacions generades per IA que després s'han de lliurar per ser indexades, la presentació presentava un replantejament amb fragments web, que serveixen com a fragments aïllats dins la pàgina. Encara és difícil trobar estàndards i encara queda molt camí per recórrer, així que és recomanable seguir-lo des de la distància. També va sortir WebMCP, que està guanyant importància en l'era de la gestió.
Google separa tres àrees quan arriba a una pàgina: capçalera, navegació i contingut principal. I dóna cada cop més pes a la tercera. Per això, moltes vegades, el títol i la descripció que mostra als resultats no són els que li hem donat a l'encapçalament.
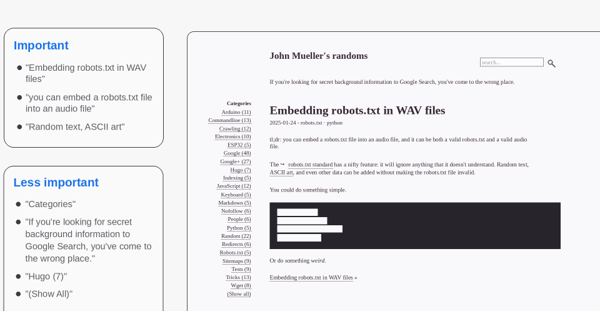
La conseqüència és pràctica: tot el que és important ha d'anar al contingut principal, però amb criteris, sense carregar-lo de tot. A la presentació ho van il·lustrar amb una entrada d'un blog personal: el títol i el text del cos es consideren importants, mentre que les categories o el peu de pàgina pesen menys.
Contingut principal enfront de contingut secundari, amb un post del blog de John Mueller com a exemple.
El que Google guarda a l'índex tampoc és la pàgina com a text. Tokenitza el contingut: separa cada paraula, registra la seva posició i l'àrea de la pàgina on es troba (capçalera, centre de foc), i assigna cada paraula a les URL on apareix. Així és com intenta entendre de què tracta el contingut i en quin format està. Té problemes greus amb llengües que no separen les paraules amb espais.
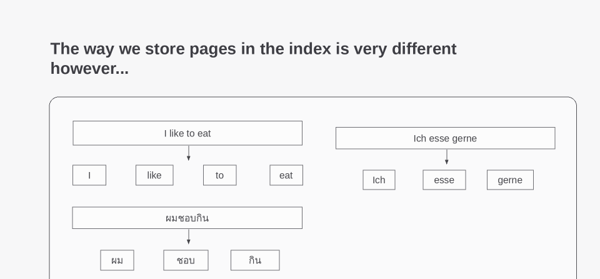
Com es separen les paraules quan es desa una pàgina a la taula de continguts, i per què les llengües sense espais ho compliquen.
Aquest no és el fragment que fan els models d'IA. Google busca context i no necessita que el contingut es talli en fragments: no té sentit optimitzar-lo en blocs pensant en Google. Per a altres models d'IA sí que pot, de moment.
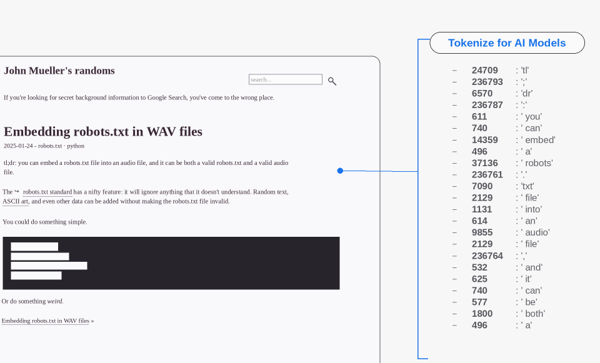
La tokenització que fan els models d'IA, que no és el que Google emmagatzema al seu índex.
Google creu que l'usuari no vol veure les mateixes pàgines, i la desduplicació també estalvia temps de rastreig per llegir noves pàgines. El procés té tres passos:
Si les pàgines són iguals, es canonitza. Si són en idiomes diferents, consulta el hreflang i el respecta. També estalvia les marques: en un rebranding, intenta relacionar la marca antiga amb la nova, de manera que qui busqui l'antiga vegi la nova. I el mateix criteri s'aplica a les migracions de contingut.
Sempre has de posar el relel canònic, tot i que Google el comprova i no sempre segueix el que li diem. Les discrepàncies es comproven a la Consola de Cerca. Concretament:
Quan el canònic que Google tria no és nostre, la causa sol ser una d'aquestes:
El primer que cal fer és comprovar que la pàgina que volem sigui indexable i que l'HTML i el renderitzat siguin correctes. Si res d'això ho explica, podem provar de redirigir l'URL indexada a la bona.
Amb hreflang hi ha una matisació: en pàgines amb el mateix idioma de molts països, Google acaba indexant una o poques URLs, per molt que les marquem totes. És recomanable decidir quina és l'URL principal i treballar perquè sigui la que triï Google.
La presentació va acabar amb set recomanacions: utilitzar redireccions en migracions, utilitzar codis de resposta HTTP i no bloquejar agents, revisar rels canònics, utilitzar hreflang per ajudar a localitzar, informar de canons estranys en fòrums, crear pàgines segures que funcionin i mantenir clars els senyals canònics.
Quan Google ja té l'HTML, fa una extracció de funcionalitats: agafa l'HTML general, desa les imatges i vídeos per separat i extreu les dades estructurades. La pàgina de resultats actual està plena de mòduls que no són els deu enllaços blaus, i gairebé tots surten d'aquí.
És més fàcil, i més barat, per a Google llegir dades estructurades que no pas interpretar contingut visible, com fa la IA. A més, et permeten donar informació que no està a la pàgina i ajuden els bots a centrar-se en contingut rellevant. Fan que la pàgina sigui elegible per a resultats rics, per a funcions del lloc i de la pàgina (nom del lloc, enmigles de fons) i per a la visibilitat a Discover. Diversos estudis suggereixen que una bona implementació pot augmentar el trànsit orgànic.
Com utilitzar-los:
Per al comerç electrònic hi ha noves funcionalitats: ara pots enviar el programa de fidelització, la política d'enviament i la categoria del producte.
Les imatges són cada cop més presents a la cerca, el descobriment i altres superfícies. Google les extreu de l'HTML amb els elements i . Les que només es refereixen com a imatges de fons CSS no estan indexades de manera fiable. Millor
; també les detecta, però és millor evitar-ho.
Dins de la imatge, Google utilitza:
La resta d'atributs s'ignoren. Sí que llegeix les paraules que envolten la imatge per obtenir context. Com a bona pràctica, és recomanable incloure-les als mapes del lloc, oferir diversos formats i mides, utilitzar AVIF i WebP sempre que sigui possible i buscar l'equilibri entre qualitat i compressió. Tenim més detalls a la publicació sobre SEO per a imatges.
El pes del vídeo depèn de la intenció de cerca. Apareix a Cerca, YouTube i Discover, ara amb previsualitzacions i moments clau. El marcatge de vídeo en HTML és molt important. Les millors pràctiques inclouen:
Les imatges i vídeos tenen els seus propis robots a Google, així que es poden bloquejar per separat amb el robots.txt o gestionar-los amb etiquetes meta de robots. Per a Discover, max-image-preview:large. I per al contingut generat per IA, la recomanació és revisar-lo abans de publicar-lo.
Google identifica l'idioma pel contingut de la pàgina, no per l'URL o el hreflang. Per això hauries d'evitar més d'un idioma a la mateixa URL. Per saber quin país apunta un lloc web, mira diversos factors:
Google no varia la ubicació del rastrejador per detectar diferents versions de la mateixa pàgina, i ignora les metaetiquetes de localització geo.region.
El SEO multilingüe està guanyant importància en el context de la IA. Es pot traduir amb IA, però cal comprovar la qualitat de la traducció. I sovint traduir no és suficient: hi ha qüestions legals, contextuals i culturals. La moneda, les ofertes i promocions, les opinions i ressenyes, la reputació de la marca o la durabilitat del producte pesen de manera diferent segons el país. La presentació ho il·lustrava amb dades de Think with Google sobre què valoren els compradors als Estats Units i Europa, i amb les diferències entre països com Alemanya i França. Traduir amb IA pot quedar curt en aquests factors i dependrà dels recursos i riscos de cada projecte.
El SEO internacional no es resol amb traduccions, ni tan sols amb un bon hreflang:
Per aprofundir, recomanem l'article d'Alizée Baudez sobre SEO internacional.
Sobre com estructurar el lloc web per mercats, tenim una entrada dedicada al SEO internacional: domini, subdomini o carpeta.
Google només indexa una part molt petita de les pàgines que troba. Intenta conservar les que donen més satisfacció als usuaris, i la selecció es fa al final, quan ja ha analitzat el contingut i els senyals. Per decidir això, cal saber si el contingut és fiable i rellevant.
L'essència no ha canviat: útil, original, ben estructurat, contingut ben escrit, amb bona metadada i esquema. El PageRank encara existeix, però s'ha refinat. Els signes que van destacar són quatre:
També hi ha senyals negatius que prenen una pàgina de la cursa: noindex, contingut caducat (unavailable_after), soft 404, duplicats i senyals de correu brossa. Els senyals dels usuaris també compten.
Dos estats de l'informe d'indexació de pàgines tenen una lectura clara:
Google tokenitza el contingut i etiqueta cada token amb l'àrea de la pàgina on es troba (per exemple, capçalera o element central). Després construeix una llista de publicacions: cada paraula s'associa amb les URLs on apareix, etiquetades per format. D'aquesta manera intenta entendre de què tracta el contingut i en quin format es troba.
Situació | Recomanació |
Elimina ràpidament les pàgines de la cerca | Sol·licitud d'eliminació a la Consola de Cerca |
Paràmetres que no volem que es rastregin (variants, filtres de cerca) | Bloqueja'ls amb robots.txt. Els canònics ajuden bé a indexar, però no controlen el rastreig |
Google reescriu títols i no ens agrada | Escriu-ne de millors. Normalment agafa el títol meta o H1; si són bons, no en prendran altres (o sí) |
Producte esgotat que tornarà aviat | 200 amb esquema esgotat d'estoc, sense 404 ni redireccionament. Indica a la pàgina que ara no ho és i, si és possible, ofereix la precomanda |
Canonical autorreferencial | Sí, per si de cas |
Disavow tool | No cal |
Lloc web desindexat per error que volem recuperar ràpidament | Envia les teves URL principals a través de la Consola de Cerca |
Si vols entendre per què Google reescriu els títols, el nostre article sobre com Google tria els títols de les pàgines ho detalla.
El contingut continua sent el rei, segons l'article, i té sentit: tot el sistema descrit fins ara existeix per decidir quin contingut val la pena guardar.
Per decidir quin contingut val la pena crear, una bona font és Google Trends, que també es va presentar a la presentació. Té dades des del 2004 fins fa pocs minuts, combina cerca de text, imatges i compres, i serveix tant tendències a llarg termini com temes actuals. És una bona eina per a estudis de màrqueting, per prendre decisions SEO o SEM i per presentar dades al client. No inclou Discover, perquè l'usuari no hi cerca.
Tot l'anterior es pot convertir en una revisió ordenada. Aquest és l'ordre que proposem, des de més ràpid i amb més impacte fins a més feina.
Les fonts oficials de cada tema, per contrastar el que hem explicat. Tota la documentació està en anglès.
I dues referències tècniques esmentades a la presentació: l' API d'Història (MDN) per a URLs en aplicacions d'una sola pàgina i Web Fragments per a la distribució d'aplicacions generades per IA.
La indexació és un tema en què s'han de parlar de SEO i desenvolupament. Moltes de les decisions que determinen si Google veu bé un lloc web (com es representa, com es generen enllaços, a què respon el servidor) són desenvolupament i es prenen abans que ningú pensi en SEO. A La Teva Web treballem amb el nostre propi equip, sense subcontractar, i això ens permet revisar aquests punts amb la persona que construeix el lloc web.
Si vols saber en quin pas del viatge es perden les pàgines del teu lloc web, escriu-nos i farem una revisió d'indexabilitat. Pots veure com treballem en SEO a la nostra agència de SEO a Barcelona i revisar els conceptes bàsics a la Guia de SEO.
Tens un projecte en ment? En volem saber més!


Indexar ja no és un tràmit: Google només guarda una part petita del que troba, i el JavaScript, la IA i els canvis a la SERP ho posen més difícil.