Bruno Díaz

Google nos invitó a la Search Central Live Deep Dive Europe 2026, el congreso que organiza para profesionales del SEO y que este año se ha celebrado en Barcelona. El primer día se dedicó a cómo rastrea Google la web. El segundo, a cómo la interpreta y decide qué guarda en el índice. Este artículo recoge ese segundo día, ordenado con un hilo común: entender cómo procesa Google el contenido de nuestra web para saber qué hacer para que se indexe.
Es el formato más técnico de los Search Central Live: sesiones largas con el equipo de Google Search y espacio para preguntar. Para una agencia que trabaja SEO y desarrollo es una ocasión de escuchar de primera mano cómo funcionan sus sistemas y contrastarlo con lo que vemos cada día en los proyectos de clientes.
Indexar ha dejado de ser un trámite. Google solo guarda una parte pequeña de lo que encuentra, y el contexto ha cambiado: hay cada vez más webs y aplicaciones construidas con JavaScript, muchas ya generadas con IA; la página de resultados incorpora resúmenes y módulos que hacen que no todo sea un enlace azul (lo tratamos en SEO en 2026), y los asistentes de IA leen la web con capacidades distintas a las de Google. Si la página no llega bien al índice, el resto del trabajo SEO no sirve de nada.
El artículo sigue el recorrido que hace una página desde que Google la encuentra hasta que decide si la guarda. En cada paso explicamos qué hace Google, dónde suelen fallar las webs y qué conviene revisar. Son nuestras notas de las ponencias, no documentación oficial de Google: para los detalles finos, la documentación de Search Central sigue siendo la referencia. Si algún concepto no te suena, nuestro Diccionario SEO los recoge.
Desde que Google encuentra una URL hasta que decide guardarla hay seis pasos:
Un problema en un paso condiciona los siguientes. Una página que Google no puede renderizar no llegará bien interpretada a la deduplicación, ni a las señales, ni al índice. Por eso lo más útil es saber en qué paso se pierde cada página.
Google no rastrea toda la web ni siempre al mismo ritmo. Lo que visita depende de lo que encuentra y de cómo responde el servidor, y eso es el crawl budget. El primer día del congreso se habló sobre todo de esto, y las respuestas del servidor son lo que más lo afecta:
Respuesta | Qué pasa | Qué hacer |
5xx (500, 502, 503) y 429 | Googlebot frena el ritmo. Si persisten, puede dejar de indexar URLs | En mantenimientos temporales, servir 503 |
Tiempos de respuesta lentos o timeouts | Cuanto más tarda el servidor, menos URLs rastrea | Mejorar el rendimiento |
5xx en el robots.txt | Google puede detener el rastreo de toda la web hasta que se recupere | Vigilar la disponibilidad del archivo |
3xx | Cada salto es una petición extra. Las cadenas son especialmente malas | Enlazar a la URL final |
Soft 404 (200 con contenido de "no encontrado") | Google sigue rastreándolas | Devolver un 404 o 410 real |
404 / 410 | No frenan el rastreo, pero Google las sigue revisitando. El 410 se elimina algo más rápido | Usar 410 si no van a volver |
200 con contenido duplicado o pobre (parámetros, filtros, paginaciones infinitas) | Consume presupuesto sin aportar valor | Controlarlo con robots.txt, canonical y enlazado |
304 Not Modified (con ETag o Last-Modified) | Google no tiene que volver a descargar la página | Implementar estas cabeceras |
Para ver estas respuestas en la práctica, tenemos la guía de Google Search Console y un post sobre cómo solucionar errores 5xx y 4xx.
Otras decisiones que se aclararon:
Cuando Google llega a una página, hace un parsing del HTML siguiendo los elementos del DOM. Primero separa lo que considera contenido principal del resto. Después lee el head (canonical, hreflang, title), extrae los enlaces y consulta las metaetiquetas robots.
Los enlaces son la forma en que Google descubre páginas nuevas, y tienen que ser . Cualquier otra solución es un riesgo.
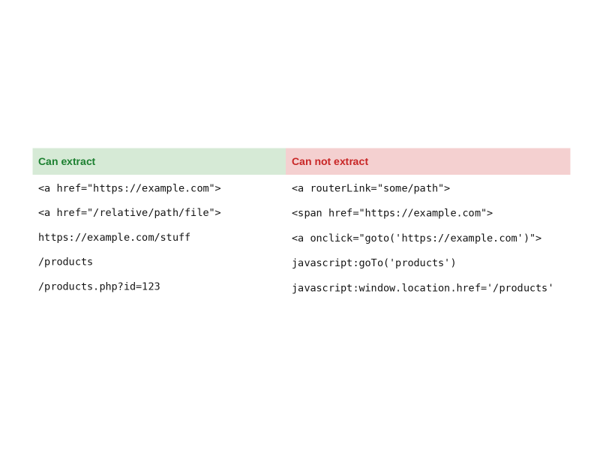
En webs hechas con frameworks de JavaScript es una de las primeras cosas que mirar: si el menú o los productos se abren con un onclick o un routerLink, Google no los ve como enlaces.
En el head se pueden indicar reglas para todos los robots o para uno concreto. Las que hay que conocer:
Directiva | Qué hace |
noindex | No indexa la página |
nofollow | No sigue los enlaces. A nivel de página tiene poco sentido; lo tiene más aplicado enlace a enlace |
none | Equivale a noindex más nofollow |
nosnippet | Indexa la página, pero sin snippets ni resúmenes en AI Overviews |
data-nosnippet | Atributo HTML (no metaetiqueta) que excluye solo una parte del contenido de los resultados |
max-snippet | Limita la extensión del fragmento, normalmente con un número de caracteres; -1 es sin límite |
max-image-preview | Define el tamaño de la imagen: ninguna, estándar o grande. Con large se puede ganar visibilidad en Discover |
max-video-preview | Fija la duración máxima de la previsualización |
notranslate | Evita la traducción en los resultados y en Chrome. Uso poco habitual |
noimageindex | Indexa el contenido, pero no las imágenes. Caso raro |
Las directivas de limitación son una decisión de negocio: si damos toda la respuesta en la página de resultados, el usuario no tiene motivo para hacer clic. Aun así, para la mayoría de webs el objetivo es la máxima visibilidad, y la combinación que recomendó la ponencia es esta:
max-image-preview:large, max-snippet:-1
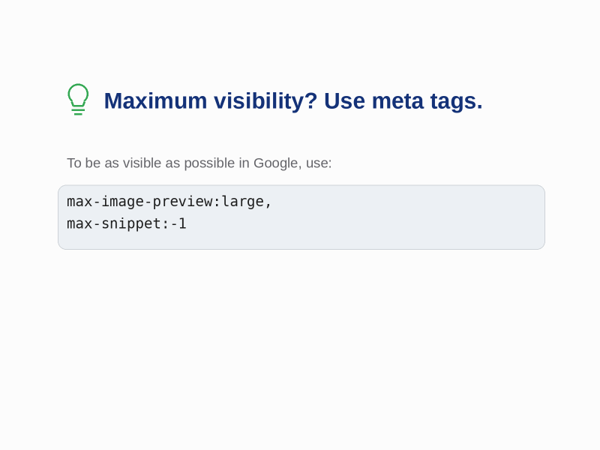
Dos precisiones más. El robots.txt manda: si bloquea el acceso a recursos que después queremos potenciar con metaetiquetas robots, estas no sirven de nada. Y se pueden incluir metaetiquetas robots mediante JavaScript, pero es inestable, sobre todo ante cambios. Mejor evitarlo.
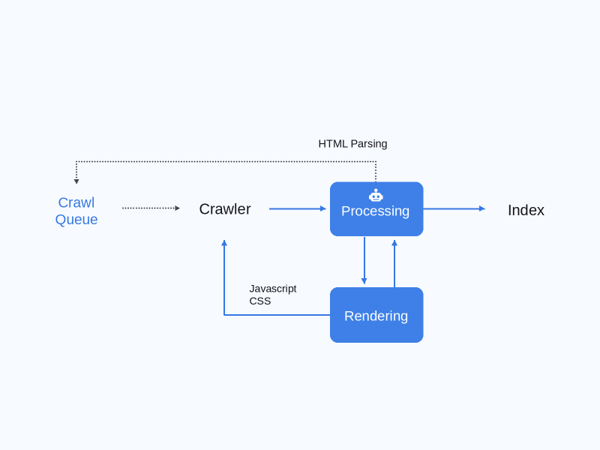
Google ha mejorado mucho el rastreo y la indexación de contenido en JavaScript, pero todavía no es perfecto. Lo que quiere es entender lo que ve una persona para saber si la página responde, y no siempre lo consigue. A la primera, casi nunca.
Una página con JS pasa por dos colas: la del HTML y, después, la de renderizado. El camino es algo más largo, pero si el contenido está bien servido, Google acaba recogiéndolo. Lo que hay que tener claro es que CSS y JS cambian cómo se ve la página, y el resultado puede ser muy distinto al del HTML desnudo. Si Google no puede renderizar bien, la mayoría de enlaces y menús no los recoge.
Si la web está hecha con React, Vue o Next.js, nuestra guía de SEO para webs con base JavaScript entra en más detalle.
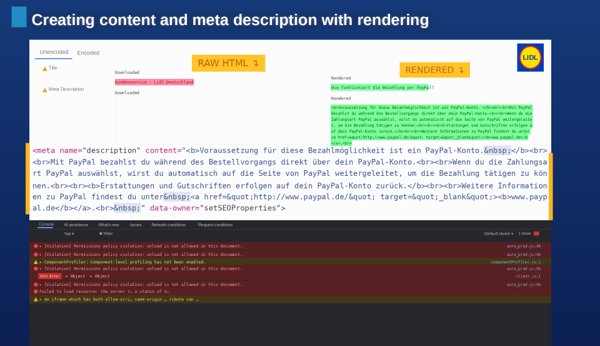
Caso mostrado en la ponencia: el title y la meta description del HTML bruto no coinciden con los del renderizado.
[Archivo: title-meta-description-html-vs-renderizado.png · ALT: Comparativa entre HTML bruto y renderizado en una página de Lidl donde el title y la meta description cambian con JavaScript]
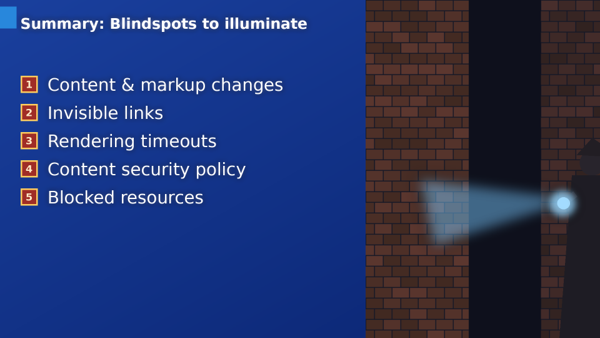
[Archivo: puntos-ciegos-javascript-seo.png · ALT: Resumen de puntos ciegos con JavaScript (cambios de contenido, enlaces invisibles, timeouts, CSP y recursos bloqueados)]
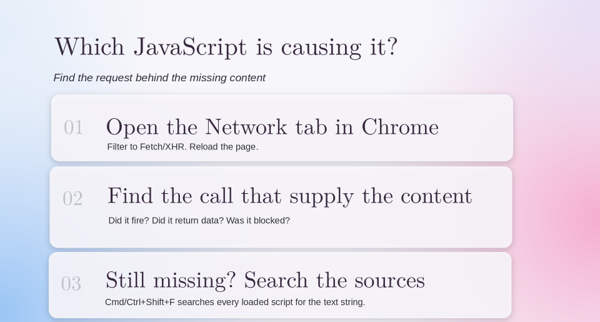
Método para encontrar la petición que hay detrás del contenido que falta.
Un detalle que conviene recordar: el servidor puede responder 200 y el contenido JS estar roto, y entonces Google lo trata como un soft 404. Nosotros lo probamos durante la sesión con una página de nuestra web: la URL estaba disponible para Google y solo mostró dos avisos de consola por recursos precargados que no se utilizaban.
Los sistemas de Google recogen bastante bien el contenido en JavaScript, pero otros asistentes de IA todavía no. Por eso lo más seguro es servirlo con SSR, es decir, renderizado en servidor. Vale la pena preguntarse también si los bots de IA pueden acceder a todo el contenido de la web, en el caso de que queramos que lo hagan.
El headless CMS es limpio y seguro, pero el resultado suele ser poco legible para Google, aunque el usuario lo vea bien. Se puede compensar en parte con un buen marcado de datos estructurados.
Para aplicaciones generadas con IA que después hay que entregar para que se indexen, la ponencia presentó el reframing con web fragments, que sirve la app como fragmentos aislados dentro de la página. Todavía cuesta encontrar estándares y queda camino, así que conviene seguirla de lejos. También salió WebMCP, que cobra importancia en la era agéntica.
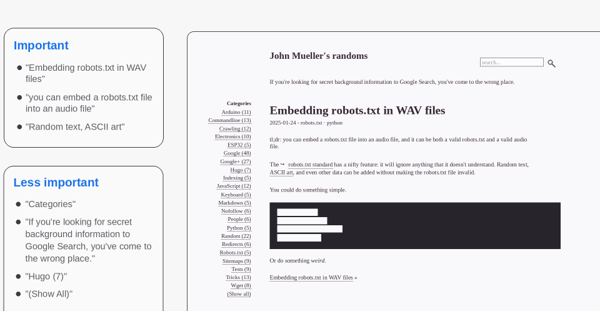
Google separa tres zonas cuando llega a una página: header, navegación y contenido principal. Y da cada vez más peso a la tercera. Por eso, muchas veces, el título y la descripción que muestra en los resultados no son los que le hemos entregado en el head.
La consecuencia es práctica: todo lo que sea importante tiene que ir en el contenido principal, pero con criterio, sin cargarlo de todo. En la ponencia lo ilustraron con un post de un blog personal: el título y el texto del cuerpo se consideran importantes, mientras que las categorías o el pie de página pesan menos.
Contenido principal frente a contenido secundario, con un post del blog de John Mueller como ejemplo.
Lo que Google guarda en el índice tampoco es la página como texto. Tokeniza el contenido: separa cada palabra, registra su posición y la zona de la página donde está (cabecera, pieza central), y asigna cada palabra a las URLs donde aparece. Así intenta entender de qué va el contenido y en qué formato está. Tiene problemas graves con las lenguas que no separan las palabras con espacios.
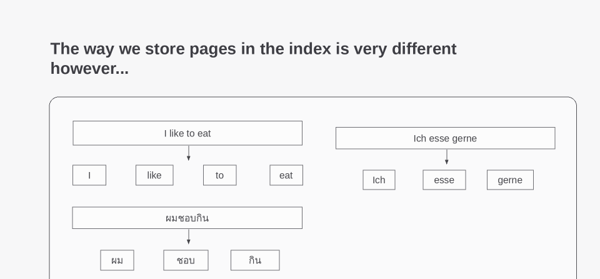
Cómo se separan las palabras al guardar una página en el índice, y por qué las lenguas sin espacios lo complican.
Esto no es el chunking que hacen los modelos de IA. Google busca contexto y no necesita el contenido cortado en fragmentos: no tiene sentido optimizarlo en bloques pensando en Google. Para otros modelos de IA sí puede tenerlo, de momento.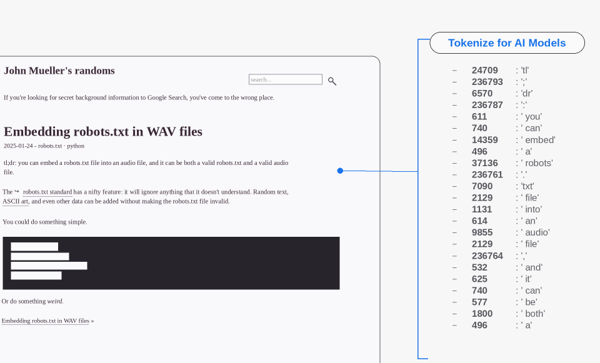
La tokenización que hacen los modelos de IA, que no es lo que Google guarda en su índice.
Google considera que el usuario no quiere ver páginas iguales, y deduplicar también le ahorra tiempo de rastreo para leer páginas nuevas. El proceso tiene tres pasos:
Si las páginas son iguales, canonicaliza. Si están en idiomas distintos, consulta el hreflang y lo respeta. También guarda las marcas: en un rebranding intenta relacionar la marca antigua con la nueva, de modo que quien busque la antigua vea la nueva. Y el mismo criterio vale para las migraciones de contenido.
Hay que poner siempre la rel canonical, aunque Google la revisa y no siempre sigue lo que le decimos. Las discrepancias se revisan en Search Console. En concreto:
Cuando la canonical que elige Google no es la nuestra, la causa suele ser una de estas:
Lo primero que hay que hacer es revisar que la página que queremos sea indexable y que el HTML y el renderizado sean correctos. Si nada de esto lo explica, se puede probar a redirigir la URL indexada hacia la buena.
Con el hreflang hay un matiz: en páginas con el mismo idioma para muchos países, Google acaba indexando una o unas cuantas URLs, por mucho que las marquemos todas. Conviene decidir cuál es la URL principal y trabajar para que sea la que Google elija.
La ponencia lo cerró con siete recomendaciones: usar redirecciones en migraciones, usar códigos de respuesta HTTP y no bloquear agentes, revisar los rel canonical, usar hreflang para ayudar a localizar, reportar canonicals extrañas en los foros, hacer páginas seguras que funcionen y mantener las señales canónicas claras.
Cuando Google ya tiene el HTML, hace una extracción de características: coge el HTML general, guarda aparte las imágenes y los vídeos y extrae los datos estructurados. La página de resultados actual está llena de módulos que no son los diez enlaces azules, y casi todos salen de aquí.
Para Google es más fácil, y más barato, leer datos estructurados que interpretar el contenido visible, como hace la IA. Además, permiten dar información que no está en la página y ayudan a los robots a centrarse en el contenido relevante. Hacen la página elegible para rich results, para funciones de sitio y de página (nombre del sitio, breadcrumb) y para visibilidad en Discover. Varios estudios apuntan a que una buena implementación puede aumentar el tráfico orgánico.
Cómo trabajarlos:
Para e-commerce hay novedades: ahora se pueden enviar el programa de fidelidad, la política de envío y la categoría de producto.
Las imágenes tienen cada vez más presencia en Search, Discover y otras superficies. Google las extrae del HTML con los elementos y . Las que solo están referenciadas como background-image de CSS no se indexan de forma fiable. Mejor
; también las recoge, pero conviene evitarlo.
Dentro de la imagen, Google usa:
El resto de atributos se ignoran. Sí lee las palabras que rodean la imagen para coger contexto. Como buenas prácticas, conviene incluirlas en los sitemaps, ofrecer varios formatos y tamaños, usar AVIF y WebP siempre que se pueda y buscar el equilibrio entre calidad y compresión. Tenemos más detalles en el post de SEO para imágenes.
El peso del vídeo depende de la intención de búsqueda. Aparece en Search, YouTube y Discover, ahora con previsualizaciones y momentos clave. El marcado de vídeo en el HTML es muy importante. Las buenas prácticas son:
Imágenes y vídeo tienen robots propios en Google, de modo que se pueden bloquear por separado con el robots.txt o gestionar con metaetiquetas robots. Para Discover, max-image-preview:large. Y sobre el contenido generado con IA, la recomendación es revisarlo antes de publicarlo.
Google identifica el idioma por el contenido de la página, no por la URL ni por el hreflang. Por eso hay que evitar más de un idioma en una misma URL. Para saber a qué país se dirige una web, mira varios factores:
Google no varía la ubicación del rastreador para detectar versiones distintas de una misma página, e ignora las metaetiquetas de localización tipo geo.region.
El SEO multiidioma gana importancia en el contexto de la IA. Se puede traducir con IA, pero hay que revisar la calidad de la traducción. Y a menudo no basta con traducir: hay cuestiones legales, de contexto y culturales. La moneda, las ofertas y promociones, las opiniones y reseñas, la reputación de marca o la durabilidad del producto pesan distinto según el país. La ponencia lo ilustró con datos de Think with Google sobre qué valoran los compradores de Estados Unidos y de Europa, y con diferencias entre países como Alemania y Francia. Traducir con IA puede quedarse corto para este tipo de factores, y dependerá de los recursos y de los riesgos de cada proyecto.
El SEO internacional no se resuelve con traducciones, ni siquiera con un buen hreflang:
Para profundizar, recomendamos el artículo de Alizée Baudez sobre SEO internacional.
Sobre cómo estructurar la web por mercados, tenemos un post dedicado a SEO internacional: dominio, subdominio o carpeta.
Google solo indexa una parte pequeñísima de las páginas que encuentra. Intenta quedarse con las que dan más satisfacción a los usuarios, y la selección se hace al final, cuando ya ha analizado contenido y señales. Para decidirlo necesita saber si el contenido es fiable y relevante.
La esencia no ha cambiado: contenido útil, original, bien estructurado y bien escrito, con buenos metadatos y schema. PageRank sigue existiendo, pero se ha refinado. Las señales que se destacaron son cuatro:
Hay también señales negativas que sacan una página de la carrera: el noindex, el contenido caducado (unavailable_after), el soft 404, los duplicados y las señales de spam. Las señales de usuario también cuentan.
Dos estados del informe de indexación de páginas tienen una lectura clara:
Google tokeniza el contenido y etiqueta cada token con la zona de la página donde está (por ejemplo, cabecera o pieza central). Después construye una posting list: cada palabra queda asociada a las URLs donde aparece, etiquetada por formato. Así intenta entender de qué va el contenido y en qué formato está.
Situación | Recomendación |
Eliminar páginas de la búsqueda rápidamente | Solicitar la eliminación en Search Console |
Parámetros que no queremos que se rastreen (variantes, filtros de búsqueda) | Bloquearlos con robots.txt. Las canonicals ayudan a indexar bien, pero no controlan el rastreo |
Google reescribe los títulos y no nos gusta | Escribir otros mejores. Normalmente coge el meta title o el H1; si están bien, no cogerá otros (o sí) |
Producto sin stock que volverá pronto | 200 con schema out of stock, sin 404 ni redirección. Indicar en la página que ahora no está y, si se puede, ofrecer preorder |
Canonical autorreferencial | Sí, por si acaso |
Disavow tool | No hace falta |
Web desindexada por error que queremos recuperar rápido | Enviar las URLs principales por Search Console |
Si quieres entender por qué Google reescribe los títulos, nuestro post sobre cómo elige Google los títulos de las páginas lo detalla.
El contenido sigue siendo el rey, según la ponencia, y tiene sentido: todo el sistema descrito hasta aquí existe para decidir qué contenido vale la pena guardar.
Para decidir qué contenido vale la pena crear, una buena fuente es Google Trends, que también se presentó en la ponencia. Tiene datos desde 2004 hasta pocos minutos atrás, combina búsqueda de texto, imágenes y shopping, y sirve tanto para tendencias a largo plazo como para temas del momento. Es una buena herramienta para estudios de marketing, para tomar decisiones de SEO o SEM y para presentar datos a cliente. No incluye Discover, porque allí el usuario no busca.
Todo lo anterior se puede convertir en una revisión ordenada. Este es el orden que proponemos, de más rápido y con más impacto a más trabajo.
Las fuentes oficiales de cada tema, para contrastar lo que hemos explicado. Toda la documentación está en inglés.
Y dos referencias técnicas mencionadas en la ponencia: la History API (MDN) para las URLs en aplicaciones de una sola página y Web Fragments para la entrega de apps generadas con IA.
La indexación es un tema en el que SEO y desarrollo tienen que hablarse. Muchas de las decisiones que determinan si Google ve bien una web (cómo se renderiza, cómo se generan los enlaces, qué responde el servidor) son de desarrollo y se toman antes de que nadie piense en SEO. En La Teva Web trabajamos con equipo propio, sin subcontratar, y eso nos permite revisar estos puntos con quien construye la web.
Si quieres saber en qué paso del recorrido se pierden las páginas de tu web, escríbenos y hacemos una revisión de indexabilidad. Puedes ver cómo trabajamos el SEO en nuestra agencia SEO de Barcelona y repasar los fundamentos en la Guía SEO.


¿Tienes un proyecto en mente? Cuéntanoslo

Indexar ya no es un trámite: Google solo guarda una parte pequeña de lo que encuentra, y JavaScript, IA y cambios en la SERP lo ponen más difícil.